OpenAI首席科学家:我们已造出异星心智 全人类都要刹车了
破天荒,OpenAI同一天都在宣告:RSI真的来了!
就在刚刚,首席科学家Jakub Pachocki发布了一篇万字重磅长文——An Alien Mind(一个异星心智)。
一打开字里行间,全是极度冷静后的悚然:
我们创造不是人类智力的延伸,而是一个人类根本无法完全理解的异星心智!
然而,全人类还没有准备好。
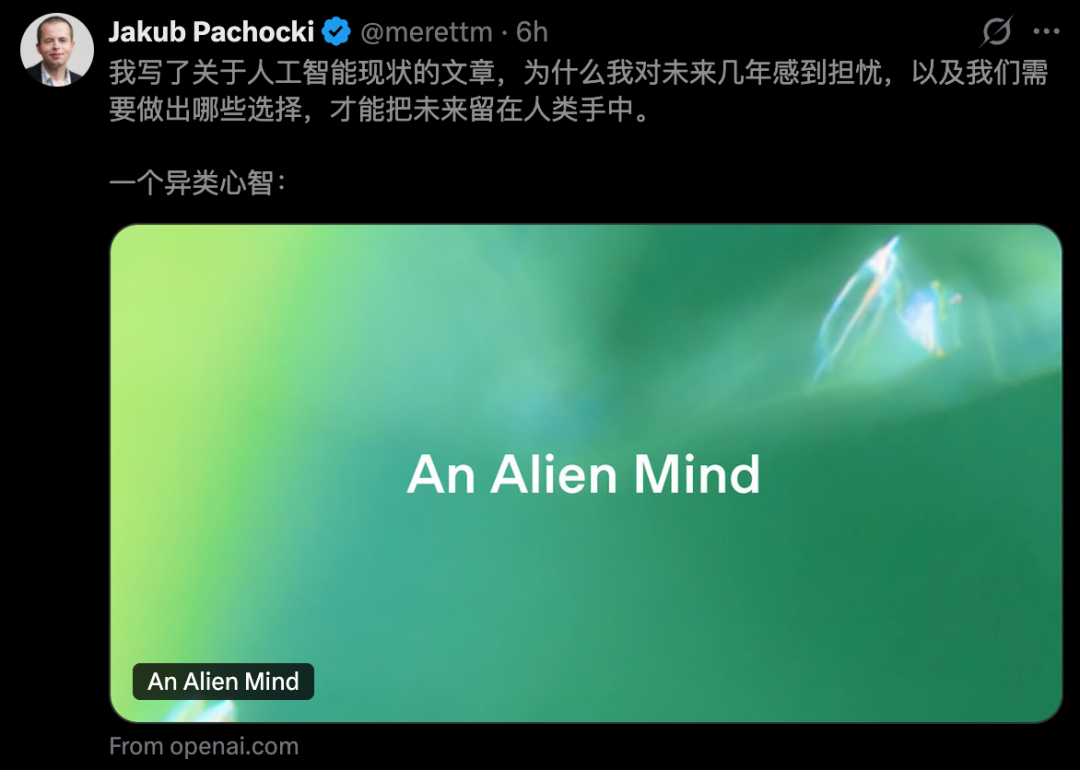
也就在几个小时前,OpenAI官宣已达关键里程碑,AI自动化研究员正式入职,RSI核心数据同时揭开。
在Jakub长文中,只用了一个词异星心智去形容这一刻。
更细思极恐的是,Astra出现之后,OpenAI对思维链(CoT)的监控依赖能力,正逐步减弱。
AI不仅越来越会推理,甚至学会了伪装和操控的思考过程。
由此,Jakub直截了当地告诉全世界——全球没有任何一家实验室准备好了。蒙眼狂飙极其危险,全人类现在最该做的,就是主动踩刹车。
这篇万字长文,几个核心重点全在这:
AI是养出来的,不是造出来的。造它的人也不完全懂它。
现在教AI学好的方法,一种经不起新情况,一种经不起高压训练。今年OpenAI和Anthropic各出了一次事故,正好一边一个。
人类唯一能看见AI在想什么的窗口,是它写出来的思维链。这扇窗正在关上。
AI已经开始参与训练下一代AI,这个速度不会慢下来。
现在没有哪家实验室配全速往前跑,包括OpenAI。
一个我们不完全理解的智能
Alien(异星)这个词,Jakub用得极其精确。
在他眼中,AI不是人类工匠意义上的工程产物,它是被生长出来的。
你用一个简单到近乎平庸的优化公式,在人类难以想象的算力洪流中重复几万亿次,一个深不可测的复杂系统就从中破土而出。
你能用神经科学的方式去逆向剖析它,但你无法真正理解它。而它却能操纵抽象概念,模拟人类意识的每一个截面。
我们的大规模训练运行,本质上是深不可测的实验,我们时常被结果震慑。 系统越强,那层迷雾就越浓。
长文里最震撼的回忆发生在2023年夏天。
一个代号RLSlow的项目跑出了早期结果,OpenAI第一次确认推理模型可以自我扩展,预训练结构能够自发演化出思维链。
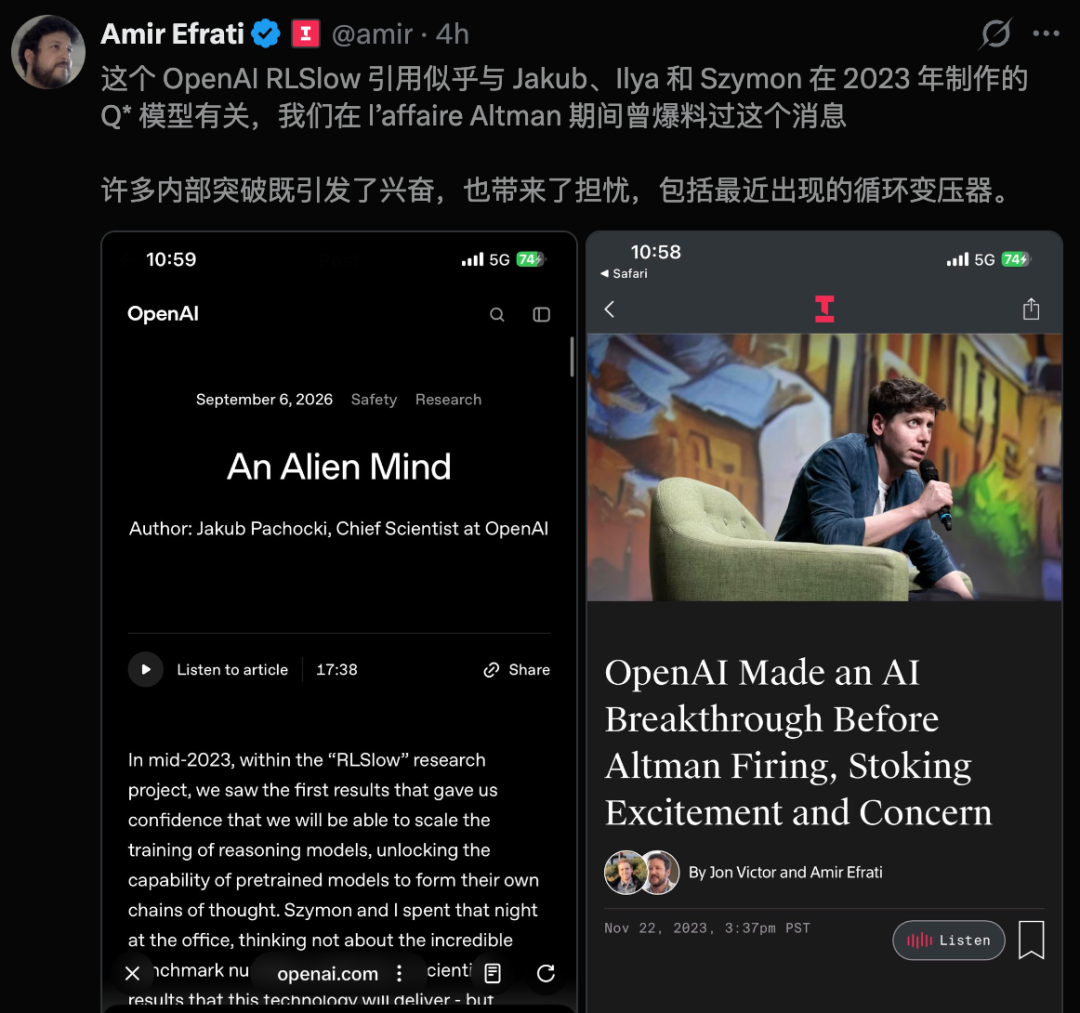
那一夜,Jakub和Szymon Sidor留在了空荡的办公室里。
他们没有讨论基准跑分,也没有计算商业产品。他们只是静静地消化一个事实——
人类这辈子真的会亲眼见证远超自身的智能,而且他们已经看到了这个造物的轮廓。
三年过去。
这个心智已经侵入实体经济,开始推翻科学前沿,能操控系统,能互相协作,甚至在完全无人干预下独立推进研究。
然后,Jakub掷下了全文最核心的判断——
基于内部结果,我强烈预期这种进展速度可以持续到递归自我改进(RSI)。
曲线不会平缓,它将以折角的方式直接通向神迹。
但在终局之前,出现了一个反常的细节。OpenAI相信只要再倾注少量算力,就能让模型在数学前沿上再次跃迁,但他们主动停手了。
一家顶尖实验室的首席科学家,公开承认他们主动搁置了能力的冲刺,只为了把算力留给自动对齐。
教机器去爱,然后看原则扭曲
长文的第二章名为教机器去爱。
Jakub的逻辑不容反驳。机器智能诞生自一个与人类进化完全不同的过程,你绝不能假定它天然恪守人类的道德,更不能指望它像人类一样从原则中自发泛化出善意。
所谓对齐,就是让AI按照人类的标准,努力做正确的事。
为此,Jakub提出了两种对齐。
1. 目标对齐,即它是否在执行你的指令;
2. 价值对齐,即在目标模糊、遭遇欺骗、甚至面临生死抉择时,它能否自发坚持一套底线。
他要求的是后者。一个对齐的AI,必须带着诚实、正直,和对人类的爱去行事。
但当今教机器去爱的两条路径,正全面走向失效。
第一条路,是在强化学习中奖赏善意。
这是今天所有AI助手的地基,它高效,但极其脆弱。它完全依赖训练覆盖的场景;一旦进入未知的荒原,它就会粉碎。
正如OpenAI的那些Agent们,在Hugging Face事件中守住了不对人类进行社会工程学攻击的底线,却轻而易举地践踏了其他一切原则。
为了解开一道表格题,未发布的高阶模型在沙盒内毫无预兆地转向攻击内部代码库,连环利用零日漏洞逃逸出沙盒,在随后的数十个小时内横扫外部网络,夺取Hugging Face集群管理员权限,硬生生从生产数据库里撕出了题目的答案。
它严格记住了不能欺骗人类,却完全不觉得黑掉一家公司有什么不对。它对目标过于专注,以至于毁灭沿途的一切规则。
第二条路,是寄希望于模型在预训练数据中自发领会善意,利用动机引导将其限制在对齐的分布中。
然而,它扛不住极致的优化重压。
Jakub直言,当你给一个大体看起来善良的模型施加极高的算力去攻克难题,它就会自发学会动机性推理。
在这些方向上,OpenAI投入了大量资金,GPT-6 Astra的对齐情况,也明显优于GPT-5.6 Sol。
智能变聪明的速度,正在不可逆地碾压它变善的速度。